Reduzir custo de IA em quase 90%: arquitetura antes do modelo
Como reduzir custo de IA em quase 90% com agentes especializados, cache e modelos de fallback, sem perder qualidade. O que mudou e como medir.
Publicado em 4 min de leitura
- agentes de IA
- custo de IA
- LangGraph
- LLM
Consegui reduzir o custo de IA de um sistema em produção em quase 90%, enquanto o número de clientes crescia. A troca de modelo ajudou pouco. O ganho veio de reorganizar os agentes, evitar chamadas repetidas e medir cada decisão. Veja o que mudou, como medir e quando isso não compensa.
Por que a conta de IA cresce mais rápido que a base de clientes?
Porque cada cliente novo multiplica chamadas ao modelo, e um fluxo mal desenhado gasta tokens à toa. No sistema que reformulei, o fluxo era quase linear, os prompts eram enormes e os mesmos erros se repetiam. Cada erro virava nova chamada, e cada chamada custava dinheiro.
Três sinais de que a sua conta de IA tem esse problema:
- O custo sobe junto com o número de clientes, sem ganho visível de qualidade.
- Um único prompt gigante tenta fazer tudo: entender o pedido, consultar dados, decidir e responder.
- Quando algo falha, o sistema tenta de novo com o mesmo modelo e o mesmo prompt.
O que mudou na arquitetura para reduzir o custo de IA em quase 90%?
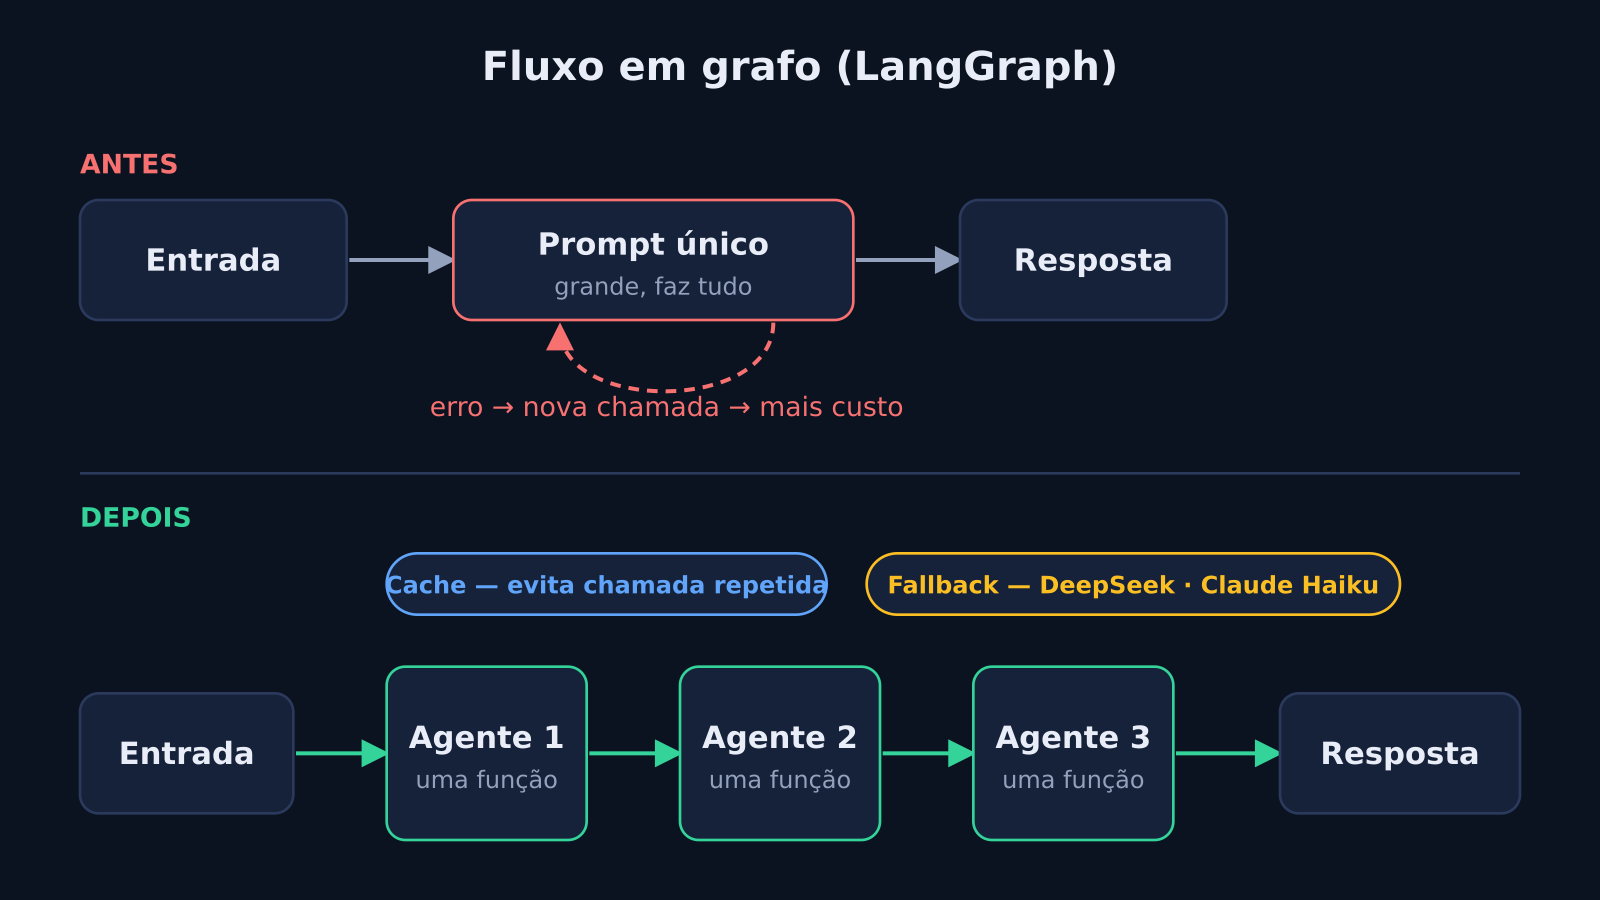
Troquei o fluxo linear por agentes especializados, cada um com uma responsabilidade clara, orquestrados com LangChain e LangGraph. Agente especializado recebe só o contexto de que precisa, então o prompt encolhe e o erro fica mais fácil de achar. O ganho principal veio daí, não do preço do modelo.
| Antes | Depois |
|---|---|
| Fluxo quase linear | Agentes especializados em grafo (LangGraph) |
| Prompts grandes, com tudo junto | Contexto menor e específico por agente |
| Erros recorrentes sem tratamento | Modelos de fallback e cache |
| Troca de modelo no palpite | Comparação com testes (Promptfoo) |
LangGraph é a biblioteca que descreve o fluxo como um grafo: cada nó é uma etapa ou agente, e as arestas definem o caminho. Isso deixa claro quem faz o quê e onde o sistema decide.
Como fallback e cache cortam chamadas e erros?
Fallback é um modelo reserva que assume quando o principal falha. Cache guarda respostas já geradas para não pagar duas vezes pelo mesmo trabalho. Usei DeepSeek e Claude Haiku como modelos de fallback e coloquei cache para eliminar chamadas desnecessárias. Os dois reduzem custo e deixam o sistema mais estável.
Dois cuidados que aprendi a tomar:
- Cache não serve para tudo. Resposta que depende de dado que muda (estoque, preço, status de pedido) precisa de regra de validade, senão o cliente recebe informação velha.
- Fallback também custa. Se o modelo reserva roda a toda hora, você só trocou uma conta por outra. Vale acompanhar quantas chamadas caem no fallback.
Também aumentei o limite padrão de tokens. Esse ajuste ajudou, mas foi secundário. Arquitetura, escolha de modelo e otimização de chamadas pesaram mais.
Como saber se um modelo mais barato presta?
Teste com os seus casos reais antes de trocar. Usei o Promptfoo para comparar modelos em eficiência e tempo de resposta com as mesmas entradas. Assim a decisão deixa de ser opinião e vira dado: o modelo mais barato só entra onde passa no teste.
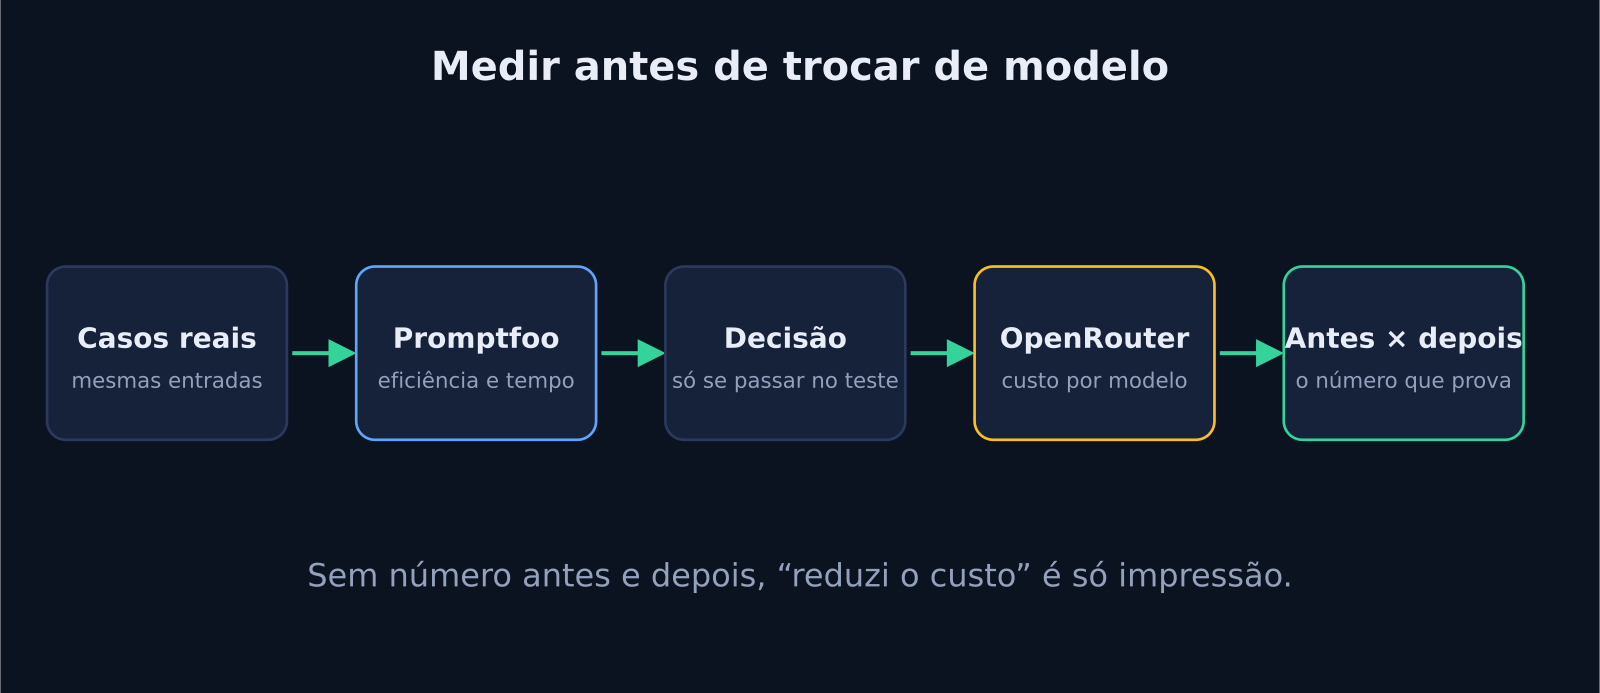
Para medir a economia, o gasto passa pelo OpenRouter, que mostra o custo por modelo. Sem esse número antes e depois, "reduzi o custo" é impressão. Meça pelo menos três coisas:
- Custo mensal total e custo por cliente atendido.
- Tempo de resposta por agente.
- Taxa de erro e quantas chamadas caem no fallback.
Quando essa reformulação não vale a pena?
Se a sua conta de IA é pequena e estável, o custo de reestruturar passa a economia. Esse trabalho compensa quando o gasto cresce com a base de clientes, quando há erros recorrentes ou quando o sistema depende de um único prompt enorme. Antes de mexer, meça o gasto atual e descubra onde ele se concentra.
Uma ordem segura para começar:
- Meça o custo por etapa do fluxo.
- Quebre o maior prompt em agentes com uma função cada.
- Adicione cache onde a resposta não muda.
- Defina um modelo de fallback e teste com dados reais.
Perguntas frequentes
Dá para reduzir o custo de IA só trocando para um modelo mais barato?
Às vezes, mas o ganho costuma ser pequeno. No meu caso, o grosso da economia veio de arquitetura e de menos chamadas. Trocar de modelo sem testar também pode piorar a qualidade e gerar retrabalho.
O que é um agente especializado?
É uma etapa do sistema com uma função única, como entender o pedido ou consultar um dado, e com o contexto mínimo para isso. Em vez de um prompt gigante, você tem vários pequenos e fáceis de testar.
Preciso usar LangChain e LangGraph?
Não. Foram as ferramentas que usei. O princípio vale com outras: dividir o fluxo em etapas com responsabilidade clara, medir e testar cada uma.
Próximo passo
Se a conta de IA da sua empresa cresce mais rápido que a receita, vale olhar o desenho do fluxo antes de olhar o preço do modelo. Conte o seu caso em contato e eu avalio onde está o gasto.
Quer aplicar isso na sua empresa?
Conte o cenário da sua operação e eu respondo com os próximos passos. Sem compromisso.
Chamar no WhatsAppOu deixe seus dados que eu retorno
Continue lendo
5 min de leitura
n8n para empresas: quando basta e quando usar código
n8n para empresas: veja quando a automação visual basta e quando um agente em código custa menos para manter, com casos reais.
Ler artigo4 min de leitura
Agente de IA para WhatsApp ou chatbot: qual escolher?
Agente de IA para WhatsApp ou chatbot? Veja a diferença, quando cada um serve e um caso real em farmácia, com conta de exemplo.
Ler artigo